

Мониторинг cron-задач: как понять, что крон не сработал
- Опубликовано:
- Обновлено
- 6 мин чтения
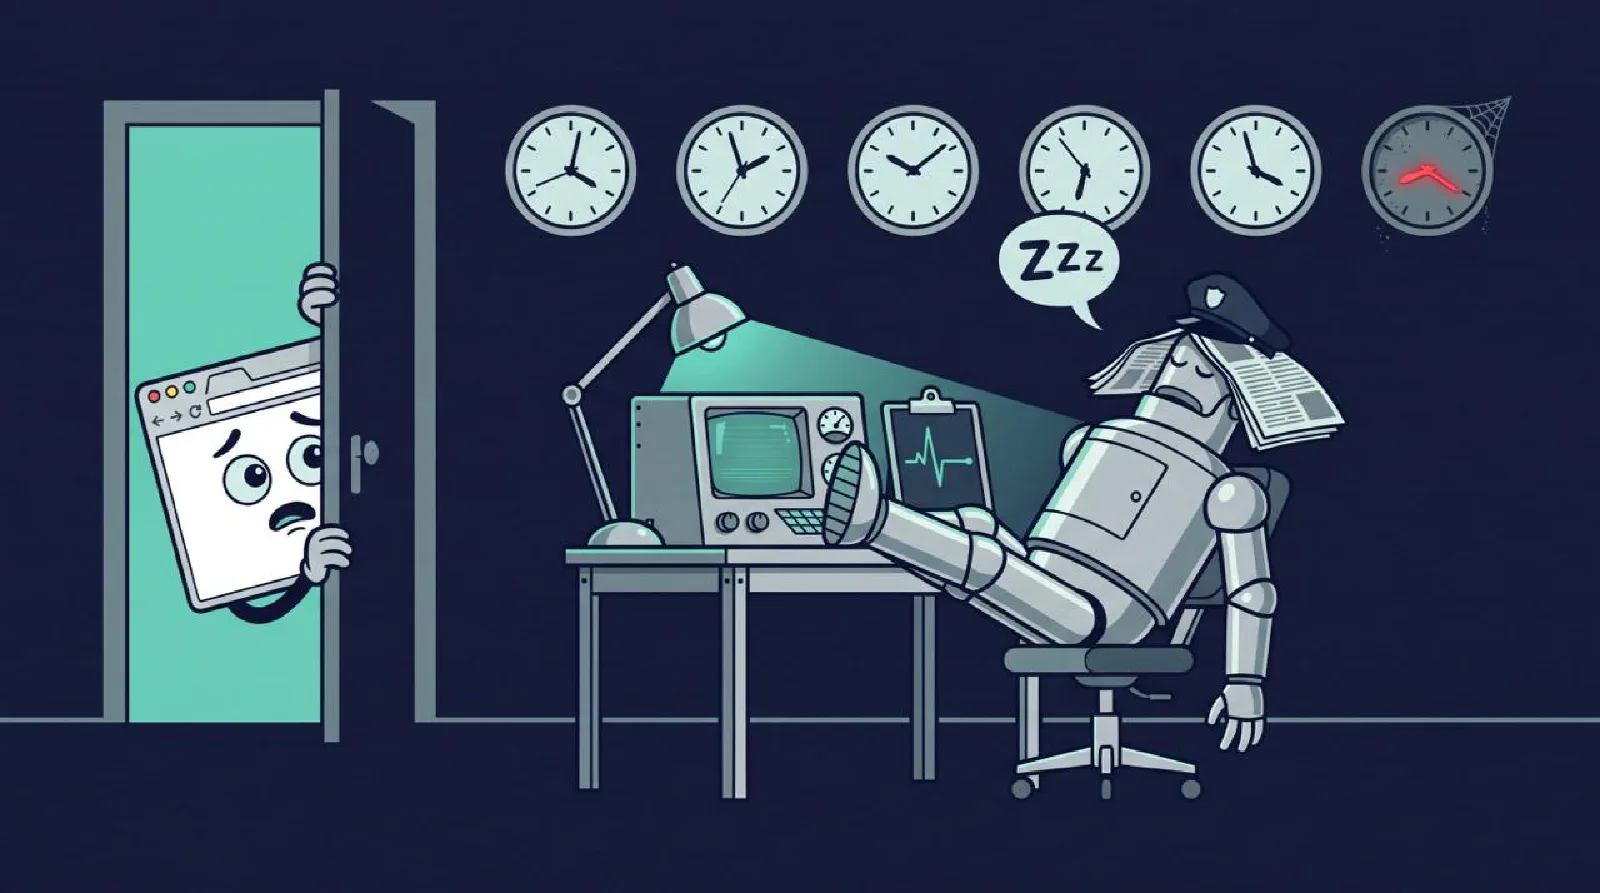
Классика жанра: бэкапы «делались» полгода, пока однажды не понадобилось восстановиться, — и выяснилось, что последнему успешному бэкапу три недели. Cron честно запускал задачу каждую ночь, задача честно падала на второй минуте, а письмо об ошибке лежало в локальном почтовом ящике root, который никто не открывал.
Коротко: cron запускает команды по расписанию, но не проверяет результат — код возврата игнорируется, вывод теряется, а если задача вообще не запустилась, узнать об этом неоткуда. Ниже разберём, почему сбои cron-задач такие тихие, как проверить, что задача действительно выполняется, и как устроен мониторинг по паттерну «пульсар» (heartbeat).
Почему сбои cron-задач незаметны
- Cron запускает команду и не интересуется результатом: завершилась задача с кодом 0 или 1 — планировщику всё равно.
- Вывод задачи по умолчанию отправляется письмом владельцу crontab (обычно root) в локальный почтовый ящик, который на серверах никто не читает. А если на сервере нет почтового агента, вывод просто выбрасывается.
- Задача может вовсе не запуститься: сервер не поднялся после перезагрузки, crond остановлен, задачу добавили в crontab не того пользователя или в строке остался неэкранированный символ
%. В crontab он означает перевод строки, поэтому команда обрезается — классический примерdate +%F. - Окружение в cron минимальное: PATH короче, переменные из
.bashrcне подгружаются, venv не активирован, docker не находится. Команда «работает руками», но падает по расписанию. - Задача может зависнуть и висеть часами, блокируя следующие запуски или съедая память.
Общий знаменатель: сбой задачи по расписанию не бросается в глаза. Падение веб-сервера пользователи замечают сразу, а мёртвый крон может молчать неделями.
Базовая диагностика: запускалась ли задача
Лог планировщика
Проверьте, запускал ли cron команду вообще:
# Debian, Ubuntu
grep CRON /var/log/syslog | tail
journalctl -u cron --since today

# RHEL, AlmaLinux, Fedora
journalctl -u crond --since today
Если строки о запуске нет — задача не стартовала: проверьте crontab (чей он, синтаксис расписания, перевод строки в конце файла) и работает ли сам crond. На системах без rsyslog файла /var/log/syslog нет — используйте journalctl.
Свой лог с кодом завершения
Сохраняйте вывод задачи и фиксируйте результат. Удобнее всего сделать это в небольшой обёртке — в одной строке crontab такая логика быстро становится нечитаемой:
#!/bin/bash
# /opt/scripts/run-backup.sh
start=$(date +%s)
/opt/scripts/backup.sh >> /var/log/backup.log 2>&1
code=$?
echo "$(date -Is) exit=$code duration=$(( $(date +%s) - start ))s" >> /var/log/backup.log
exit $code
Так появляется минимальная история: когда задача запускалась, сколько выполнялась и чем закончилась. Внутри скрипта символ % можно использовать свободно — экранировать его нужно только в самой строке crontab.
MAILTO
Строка MAILTO=ops@example.com в начале crontab даёт хоть какой-то сигнал: cron пришлёт письмо, если задача что-то вывела. Но для этого на сервере должна работать отправка почты, а письма теряются в спаме и не превращаются в алерты. Это подстраховка, а не мониторинг.
flock против параллельных запусков
Если задача может выполняться дольше интервала между запусками, защитите её от наложения:
flock -n /var/lock/backup.lock /opt/scripts/backup.sh
С ключом -n второй экземпляр не ждёт освобождения блокировки, а сразу завершается с ошибкой.
timeout против зависаний
Ограничьте время выполнения, чтобы зависшая задача превратилась в обычную ошибку:
flock -n /var/lock/backup.lock timeout 2h /opt/scripts/backup.sh
Если задача не уложится в два часа, timeout завершит её и вернёт код 124 — это будет видно в логе.
Общая проблема всех этих способов: они срабатывают, только когда сервер жив и кто-то смотрит в логи или почту. Если сервер умер целиком, не поднялся crond или потерялся crontab, локальная диагностика молчит вместе с задачей. Нужен сигнал извне.
Паттерн «пульсар»: отчёт извне
Суть паттерна: в конце успешного запуска задача «отчитывается» внешнему сервису — отправляет HTTP-запрос на уникальный URL. Сервис знает, как часто должен приходить такой сигнал, и если он не пришёл вовремя (с учётом допустимой задержки), поднимает тревогу.
В crontab это одна строка:
0 3 * * * /opt/scripts/run-backup.sh && curl -fsS -m 10 --retry 3 https://api.pingera.ru/v1/heartbeats/<ID>/ping > /dev/null
Оператор && гарантирует, что сигнал уйдёт только при нулевом коде завершения, а -m и --retry не дают сетевому сбою подвесить задачу или потерять отчёт.
Что это ловит:
- задачу, которая упала или зависла, — сигнала нет;
- сервер, который не поднялся после перезагрузки или обновления;
- остановленный crond и потерянный crontab — в логах пусто, а сигнал не приходит;
- сбитое расписание — задача стала запускаться реже, чем задумано, например после неудачной правки crontab.
Два правила. Первое: сигнал отправляется только после успеха. Отчёт в начале задачи маскирует падение на последнем шаге. Второе: допустимая задержка должна с запасом перекрывать разброс времени выполнения — иначе медленный, но успешный запуск будет вызывать ложные алерты.
Чек-лист мониторинга cron-задач
- Лог каждого запуска: время старта, длительность, код завершения.
- Алерт на ненулевой код возврата — через обёртку или сборщик логов, а не только через MAILTO.
- flock для защиты долгих задач от параллельных запусков.
- timeout для каждой долгой задачи: зависание должно превращаться в ошибку.
- Полные пути и явное окружение: PATH в crontab, активация venv, полный путь к docker.
- Пульсар для критичных задач: бэкапов, начислений, синхронизаций, рассылок.
- Инвентаризация: у каждой задачи в crontab есть владелец. «Ничейных» задач быть не должно.
Как устроены пульсары Pingera
Пульсары Pingera — готовая реализация этого паттерна. Для каждой задачи вы создаёте пульсар, задаёте ожидаемый период и допустимую задержку и получаете уникальный URL вида https://api.pingera.ru/v1/heartbeats/<ID>/ping. Сигнал можно отправить GET- или POST-запросом. В POST можно передать JSON с подробностями запуска — например, длительность или число обработанных записей, — и эти данные вместе с адресом отправителя сохранятся в истории сигналов.
Ключевое свойство — проверка работает снаружи вашей инфраструктуры. Ей всё равно, что именно случилось: упала задача, завис скрипт или умер весь сервер, — отсутствие сигнала будет замечено в любом случае. Если сигнал не пришёл в срок и допустимая задержка истекла, пульсар переходит в статус «недоступен» и присылает алерт, а когда задача снова отчитается — уведомление о восстановлении.
Алерты приходят в Telegram, MAX, на почту, по SMS или в вебхук — туда, где дежурная команда действительно их увидит, а не в локальный ящик root. Для каждого пульсара можно выбрать свои каналы. Менять сами скрипты не нужно — достаточно дописать в crontab вызов curl. Пошаговая настройка, включая создание пульсара через API, — в статье «Пульсары — cronjob-мониторинг с Pingera».
Начать можно на бесплатном тарифе; командам с продакшн-задачами подойдут тарифы Про — от 1800 ₽/мес (при оплате за год два месяца бесплатно).
Часто задаваемые вопросы
Чем пульсар лучше логов?
Логи отвечают на вопрос «что случилось», но только когда вы их читаете. Пульсар отвечает на вопрос «жива ли задача вообще» — постоянно и без вашего участия, в том числе когда сервер не загрузился и логи писать некому.
Что делать, если задача выполняется дольше обычного?
Заложите в допустимую задержку пульсара запас относительно реального времени выполнения. А чтобы задача не висела бесконечно, ограничьте её время утилитой timeout: если задача не уложится в лимит, она будет завершена с ошибкой, сигнал не уйдёт — и вы получите алерт.
Можно ли отправлять сигнал в начале или в середине задачи?
Не стоит. Сигнал должен уходить только после успешного завершения — иначе падение на последнем шаге останется незамеченным, а мониторинг будет показывать, что всё в порядке.
Как мониторить Kubernetes CronJob и systemd-таймеры?
Так же, как обычный cron: вызовите curl после основной команды. В Kubernetes CronJob это может быть sh -c "/app/job && curl -fsS ..." в команде контейнера. В systemd-сервисе с Type=oneshot удобно использовать ExecStartPost=: он выполняется только после успешного завершения основной команды.
Итог
Cron — один из немногих слоёв инфраструктуры, который может месяцами не работать незаметно: планировщик не проверяет результат, а локальные логи видит только тот, кто их открывает. Минимальный набор: лог с кодом завершения, flock, timeout и алерты на ошибки. Для критичных задач — пульсар: Pingera сообщит, если задача не отчиталась вовремя, даже когда молчит весь сервер.